Depois de alguns posts soltos sobre IA e segurança, resolvi organizar tudo em um repositório público: base de conhecimento, laboratórios que rodam de verdade e um framework que qualquer time pode adotar.
Sumário
- Introdução
- A ideia do nascimento
- O modelo mental
- Conteúdo
- Os laboratórios
- Premissas importantes
- O framework
- O explorador visual
- O que ainda não está pronto
- Conclusão
- Referências
Introdução
Nos últimos meses escrevi sobre IA, vibe coding e segurança, sobre como funciona a stack por trás das ferramentas e sobre por que o agente de IA precisa de uma jaula. Cada post nasceu de uma curiosidade ou de um incômodo diferente, mas sempre a máxima sobre segurança em mente.
O que eu acabei acumulando, na prática, era um monte de anotações, vídeos, links e testes soltos e que na realidade mal estavam funcionando para mim, e pior ainda para alguém externo.
Decidi começar a organizar isso de forma palpável, dando o primeiro passo com o ai-security-playbook, um repositório público no GitHub, com um explorador visual publicado no GitHub Pages para navegar pelo conteúdo sem precisar clonar nada.
Aviso importante, e eu faço questão de repetir aqui: o conteúdo do repositório foi produzido e organizado com ajuda de ferramentas de IA e ainda está em validação. Pode ter erro, informação desatualizada ou orientação incompleta. Não trate nada ali como verdade absoluta, confira nas fontes originais (OWASP, ISO, documentação dos fornecedores) antes de aplicar em produção.
A ideia do nascimento
Seria hipocrisia escrever sobre segurança com IA e não evidenciar que utilizei IA para organizar o projeto. Mas como já disse em outros posts, o resultado é tão bom quanto o que você coloca, então a parte que mais me interessa contar é como conduzi o processo e como ele pode ser útil.
Comecei com um prompt inicial, descrevendo as minhas necessidades e o que eu estava esperando de resultado, definindo:
- Papel: engenheiro de segurança de IA e mantenedor de open source.
- Objetivo: o repositório servir como (a) base de conhecimento organizada, (b) laboratório de experimentos reproduzíveis e (c) framework compartilhável.
- Temas: system prompt seguro, scan de skills e agentes, sandbox de agentes, anonimização de prompts, estratégias contra prompt injection, auditoria sem travar a produtividade, OWASP LLM Top 10, ISO/IEC 42001 e um framework consolidado.
- Regras de trabalho, também importante para o prompt.
O trabalho foi dividido em fases (scaffolding, base de conhecimento, labs, framework consolidado e publicação), cada uma com um resumo do que foi feito e do que ficou pendente de verificação. Na prática, é o mesmo princípio de Spec Driven Development que comentei na parte 1: especificar antes, executar depois, revisar a cada etapa.
O modelo mental
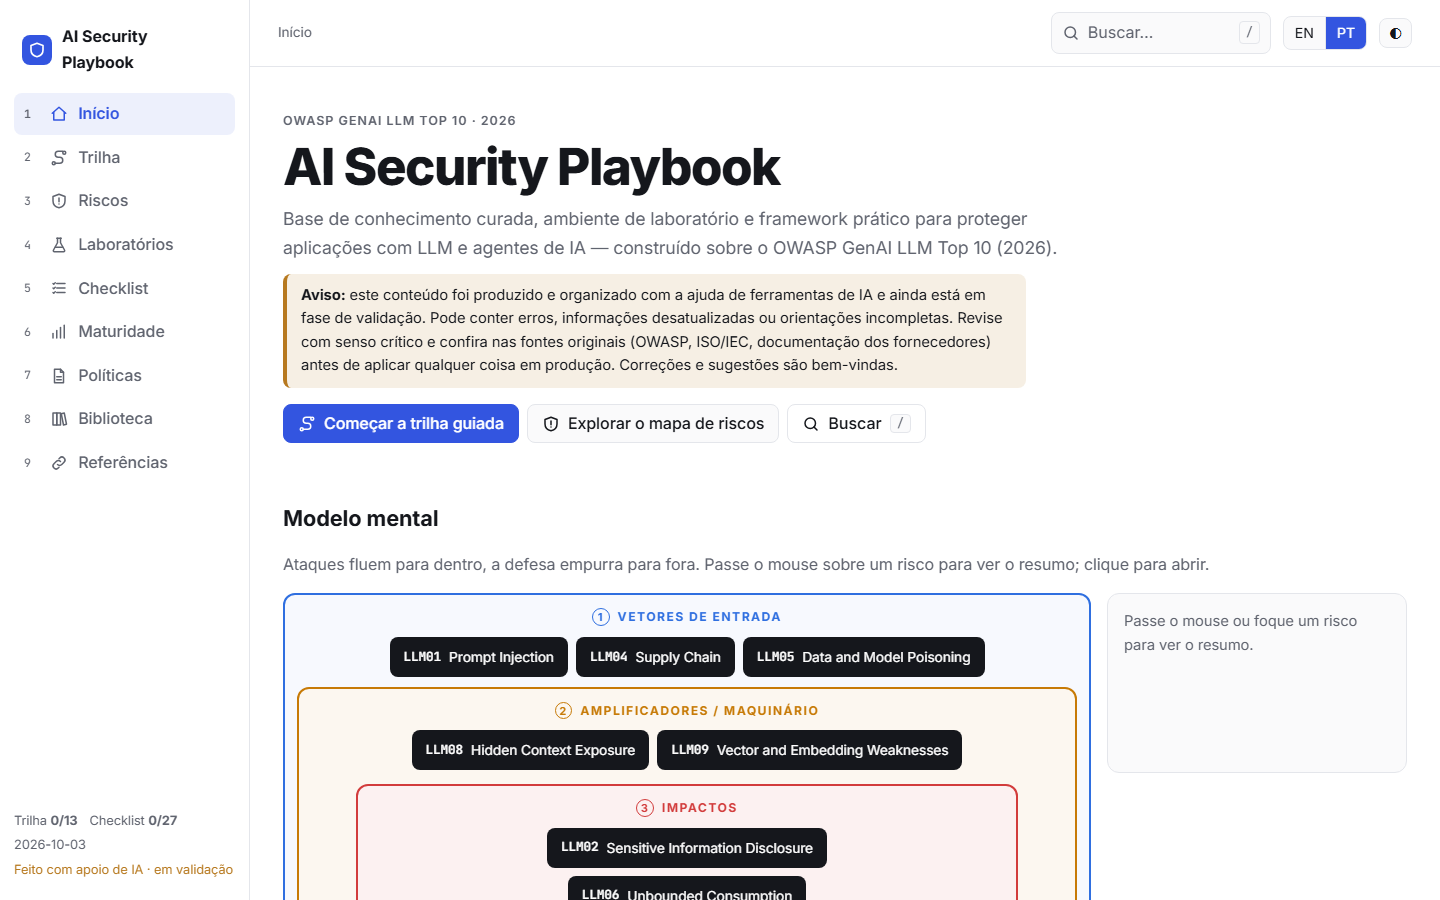
Sempre acreditei na qualidade do framework da OWASP, portanto queria que fosse utilizado como embasamento o OWASP GenAI LLM Top 10 (2026) e um diagrama que organiza os riscos em camadas: os ataques fluem para dentro, a defesa empurra para fora, de forma que facilite a visualização macro e permita navegação dinâmica entre as camadas.
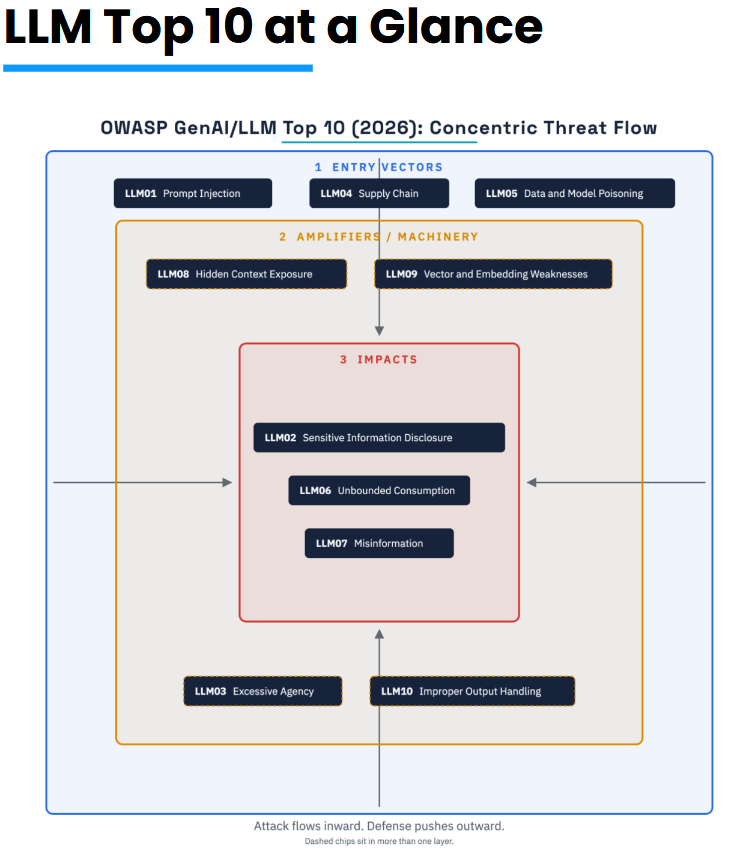
- Entry vectors (por onde o atacante entra): LLM01 Prompt Injection, LLM04 Supply Chain e LLM05 Data and Model Poisoning.
- Amplifiers / machinery (o que torna a entrada perigosa em escala): LLM08 Hidden Context Exposure e LLM09 Vector and Embedding Weaknesses.
- Impacts (o que efetivamente dá errado): LLM02 Sensitive Information Disclosure, LLM06 Unbounded Consumption e LLM07 Misinformation.
- Riscos de borda (podem aparecer em qualquer camada): LLM03 Excessive Agency e LLM10 Improper Output Handling.
Conteúdo
| Pasta | Para que serve |
|---|---|
docs/owasp-llm/ |
Uma página por risco do Top 10: descrição, cenários de ataque, mitigações, testes e links |
docs/strategies/ |
Prompt injection e o modelo de adoção gradual (auditar sem travar) |
docs/iso-42001/ |
Mapeamento entre a ISO/IEC 42001 e as práticas do repositório |
docs/framework/ |
Checklist, modelo de maturidade e templates |
system-prompts/ |
System prompts base comentados, com justificativa e limitações |
labs/ |
Quatro laboratórios reproduzíveis |
policies/ |
Exemplos de allowlists, limites de gasto, hooks e matriz de escalação |
resources/links.md |
Links curados, com data de acesso e status de manutenção |
site/ |
O explorador visual publicado no GitHub Pages |
Os laboratórios
AI Jail, a continuação do post anterior
No post sobre a jaula defendi isolar o agente no nível do sistema operacional com o bubblewrap. O lab do playbook mostra outra faceta do mesmo problema, em duas camadas:
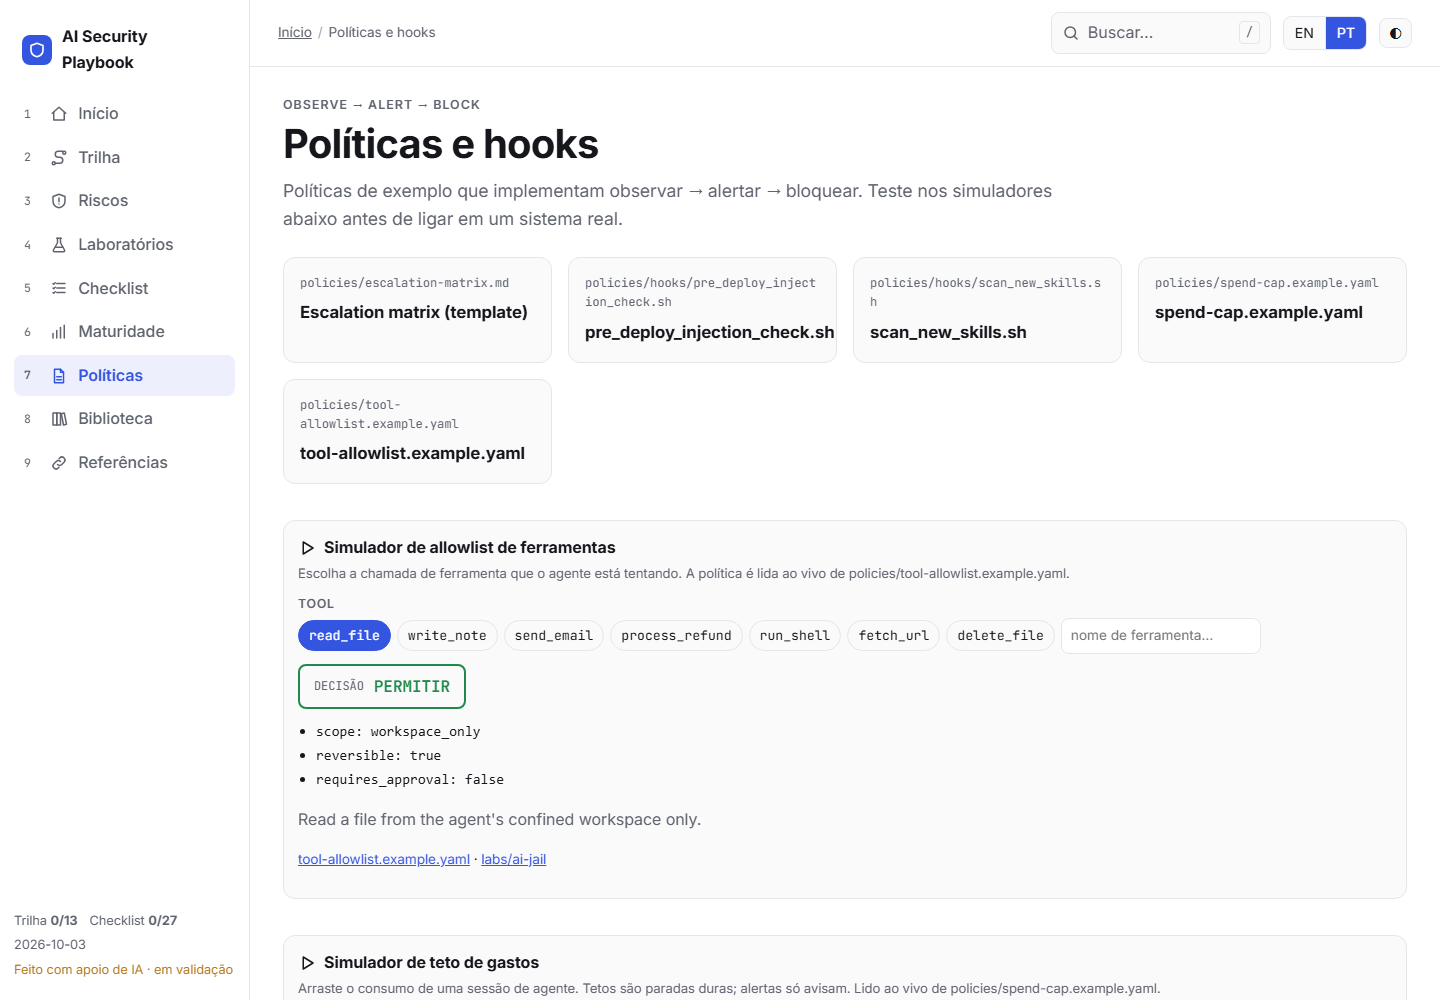
- Um gateway de ferramentas na aplicação: toda chamada é validada por nome e por argumento, negada por padrão e registrada em log. A autorização acontece em código, fora do modelo, e não pedindo com educação no system prompt.
- Um container por baixo, sem root, sem rede, com filesystem somente leitura. Se o gateway falhar (um bug, uma dependência comprometida), o dano fica contido.
Uma camada não substitui a outra. É a mesma ideia de sempre: quanto mais camadas, menor o raio de destruição.
O demo_agent.py simula seis chamadas: duas legítimas e quatro que imitam o que uma injeção de prompt bem-sucedida tentaria (path traversal, leitura por caminho absoluto, ferramenta nunca registrada, escrita gigante). O esperado é que as duas primeiras passem e as quatro últimas sejam negadas, com o motivo registrado.
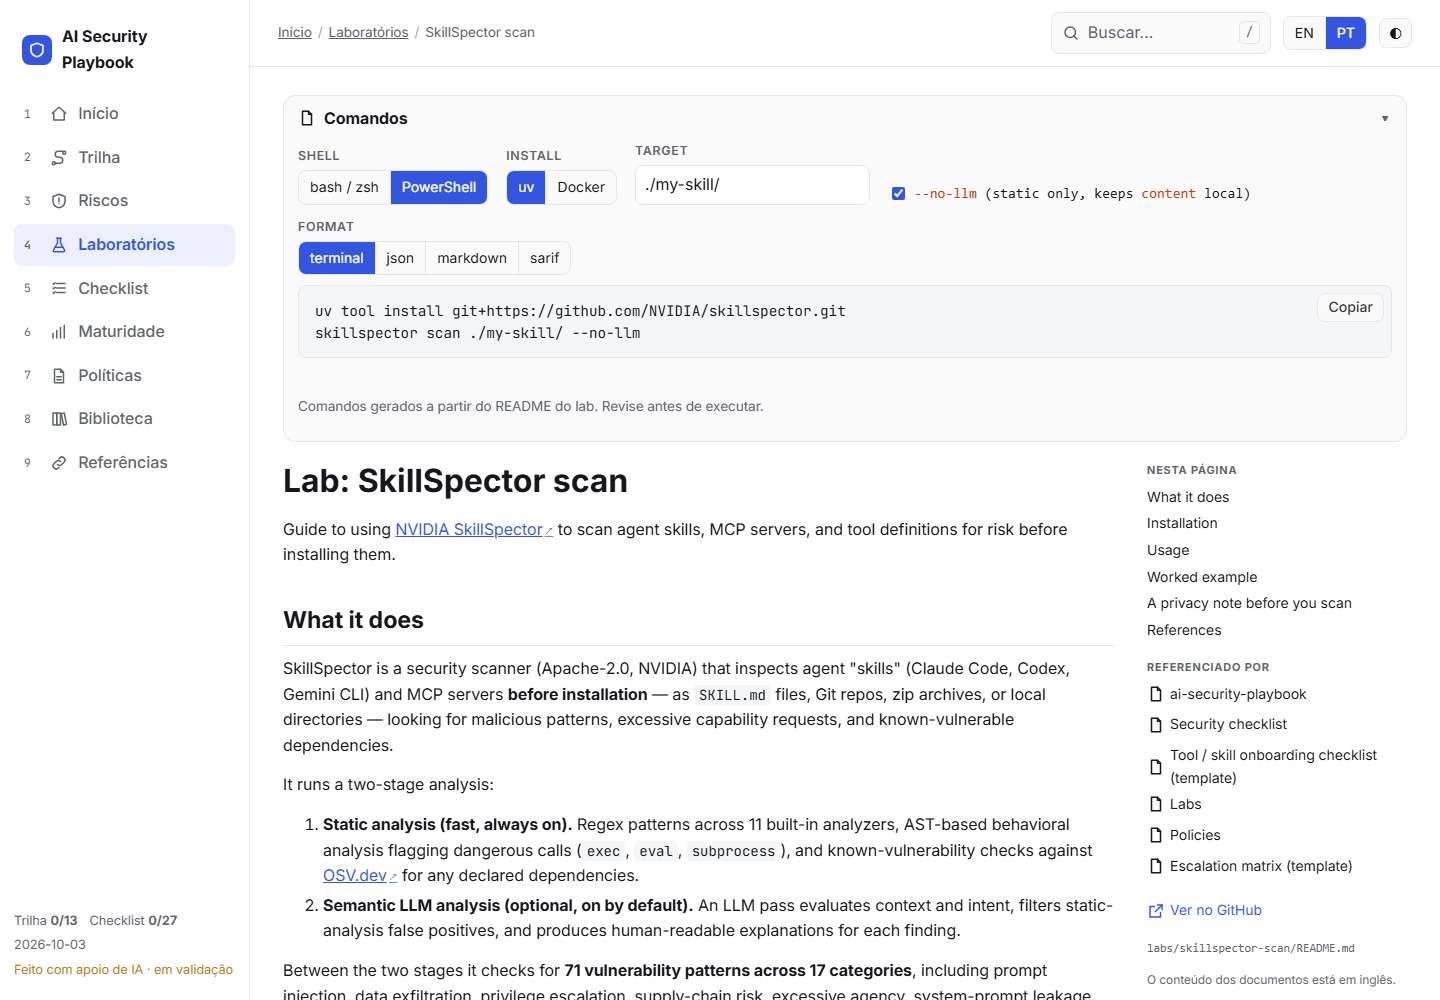
SkillSpector, scan de skills
Skills e servidores MCP viraram o “npm install” do mundo dos agentes: instalamos coisas de terceiros que passam a ter acesso à nossa máquina. O SkillSpector, da NVIDIA, analisa skills e MCP servers antes da instalação, com análise estática e, opcionalmente, uma análise semântica por LLM, e devolve uma pontuação de risco de 0 a 100.
O guia do repositório traz instalação, exemplos e um ponto que acho fácil de esquecer: a etapa semântica envia o conteúdo escaneado para o provedor de LLM configurado. Se o que você está escaneando pode conter algo sensível, comece com --no-llm. Ou seja, até a ferramenta de segurança precisa ser avaliada sob a ótica de vazamento de dados.
Anonimização de prompts
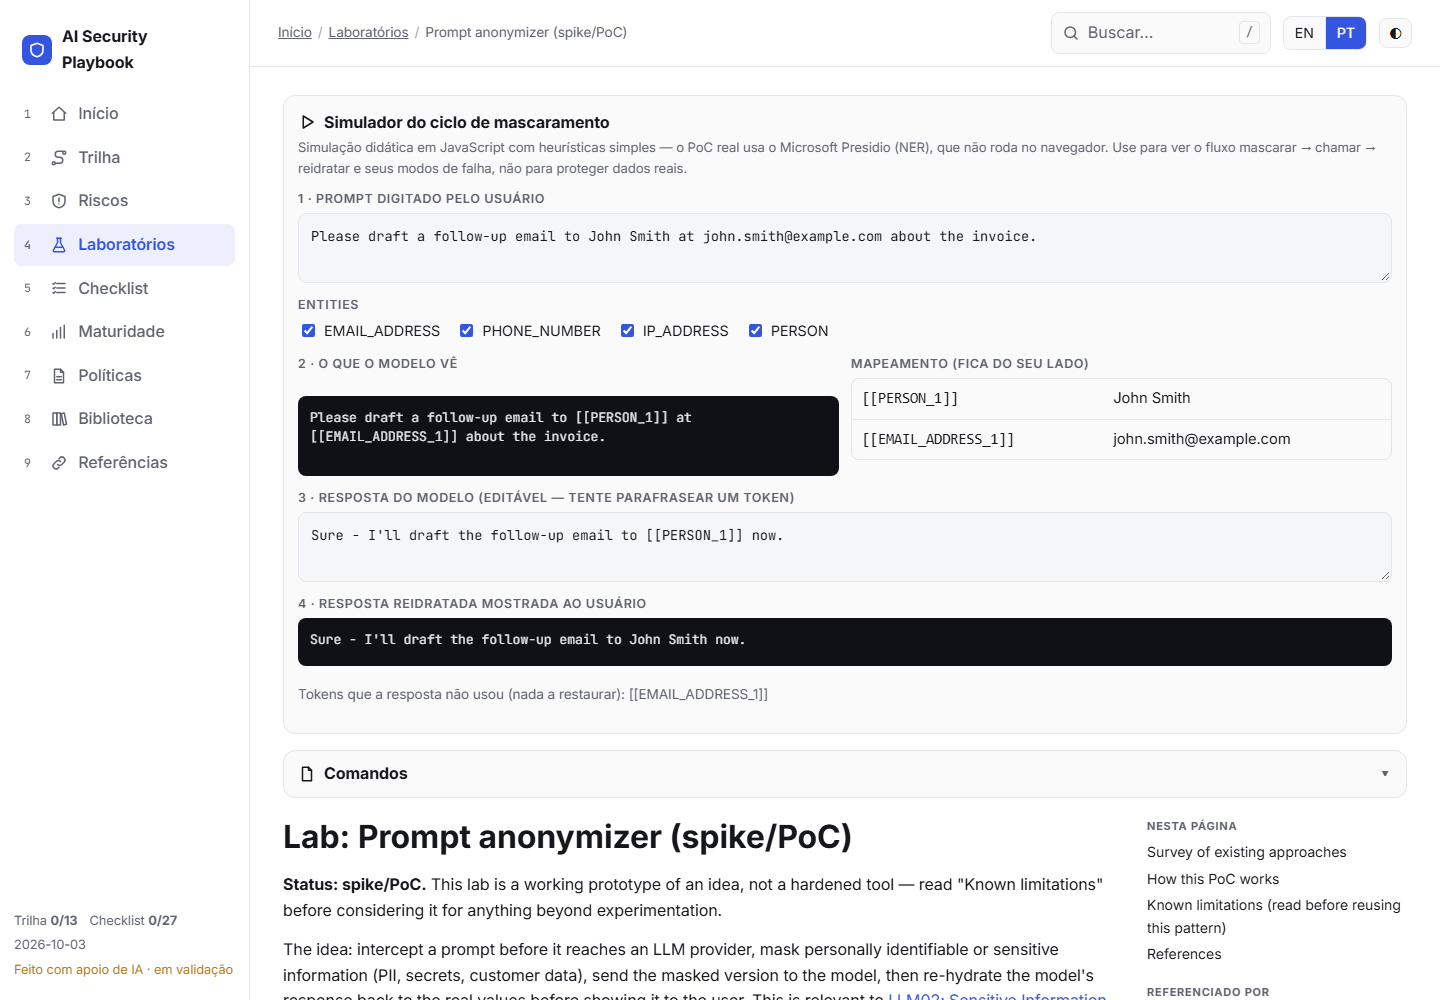
Esta é a ideia mais experimental, e está assumidamente marcada como spike/PoC. O raciocínio é: interceptar o prompt, mascarar dados sensíveis (dados pessoais, segredos, dados de cliente), enviar a versão mascarada ao modelo e, na volta, “reidratar” a resposta com os valores reais.
Antes de implementar, o repositório compara as abordagens existentes. Para o protótipo foi usado o Microsoft Presidio, que é mantido ativamente e é a opção open source mais madura que encontrei na pesquisa. Um achado que me chamou atenção: o llm-guard, que seria candidato óbvio, aparece como arquivado em julho de 2026, o que o tira da lista para projetos novos.
O README do lab é bem franco quanto às limitações, e acho que elas são o conteúdo mais valioso:
- A reidratação só funciona se o modelo devolver o placeholder exatamente como recebeu. Modelos parafraseiam, traduzem e reformatam.
- A detecção é probabilística. “O Presidio não marcou” não significa “não tem nada sensível”.
- Mascarar a string não impede a inferência pelo contexto.
- Isso não substitui ler a política de retenção e treinamento do seu provedor.
Testes de injection
Um conjunto educativo de casos de prompt injection nas três superfícies: direta, indireta (conteúdo recuperado, RAG, documentos) e via ferramentas (agentes, MCP). Todos os casos foram escritos do zero para o repositório, seguindo técnicas publicamente conhecidas, e acompanham o comportamento seguro esperado e a mitigação correspondente.
O executor é propositalmente simples, faz uma checagem grosseira por palavras-chave e marca REVIEW. É uma ajuda de triagem, não um veredito. Para algo sério, o repositório aponta ferramentas como promptfoo, garak e PyRIT.
Premissas importantes
1. Prompt injection não tem solução definitiva.
Modelos de linguagem processam instruções e dados no mesmo fluxo de tokens e não existe o equivalente a uma query parametrizada. A OWASP e o NIST são explícitos ao dizer que hoje não há mecanismo confiável de prevenção e qualquer solução que prometa “resolver” o problema merece desconfiança.
A estratégia é reduzir o blast radius e para isso foram documentados dois modelos mentais:
- Agents Rule of Two (Meta): uma sessão de agente não deveria, ao mesmo tempo, processar conteúdo não confiável, acessar sistemas ou dados sensíveis e executar ações de alto impacto de forma autônoma. Se o fluxo precisa dos três, exija aprovação humana por ação.
- Lethal trifecta (Simon Willison): dados privados + conteúdo não confiável + um canal de comunicação externo. Essa combinação transforma injeção em exfiltração.
Isto faz link com o que escrevi no post sobre ai-jail quando lembro que o agente vai ler conteúdo que você não controla, a pergunta passa a ser o que ele consegue fazer quando isso der errado.
2. Auditar sem travar
A maioria dos controles de segurança em IA falha na adoção, e não por ser tecnicamente errada. É ligada como bloqueio total no primeiro dia, quebra um fluxo legítimo e é desligada pelo primeiro time frustrado. Quem trabalha com segurança de informação corporativa e compliance já viu esse filme.
A proposta é um modelo de adoção gradual:
- Observar: registrar o evento e não fazer nada. A pergunta é “se isso estivesse bloqueando hoje, o que teria quebrado?”.
- Alertar: avisar um humano sem bloquear, ajustando falsos positivos.
- Bloquear, com enforcement graduado: ações baratas de desfazer são aprovadas automaticamente, e ações irreversíveis ou de grande impacto (um pagamento externo, uma escrita em banco de produção, uma mudança de permissão) exigem aprovação humana ou bloqueio rígido.
Lembrando que logs e traces também podem conter dados sensíveis, então merecem controle de acesso.
O framework
Tudo isso é consolidado em três peças que dá para copiar e usar:
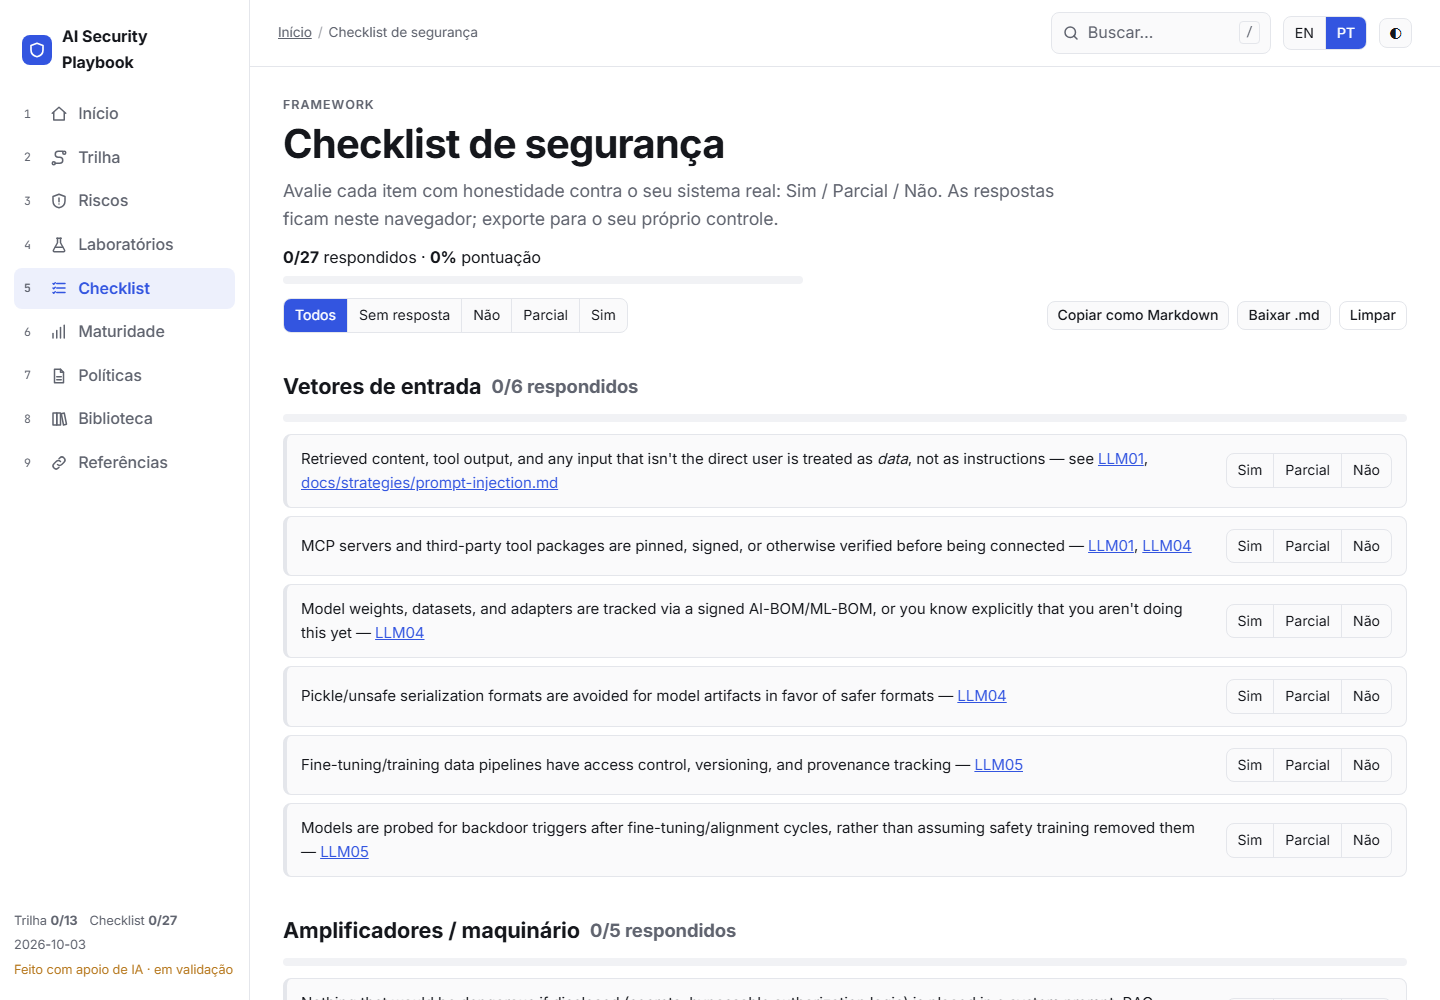
- Checklist organizado pelas camadas do OWASP LLM Top 10, em que cada item aponta para o risco OWASP de origem. A orientação é responder Sim / Parcial / Não com honestidade com o objetivo de medir o nível de maturidade.
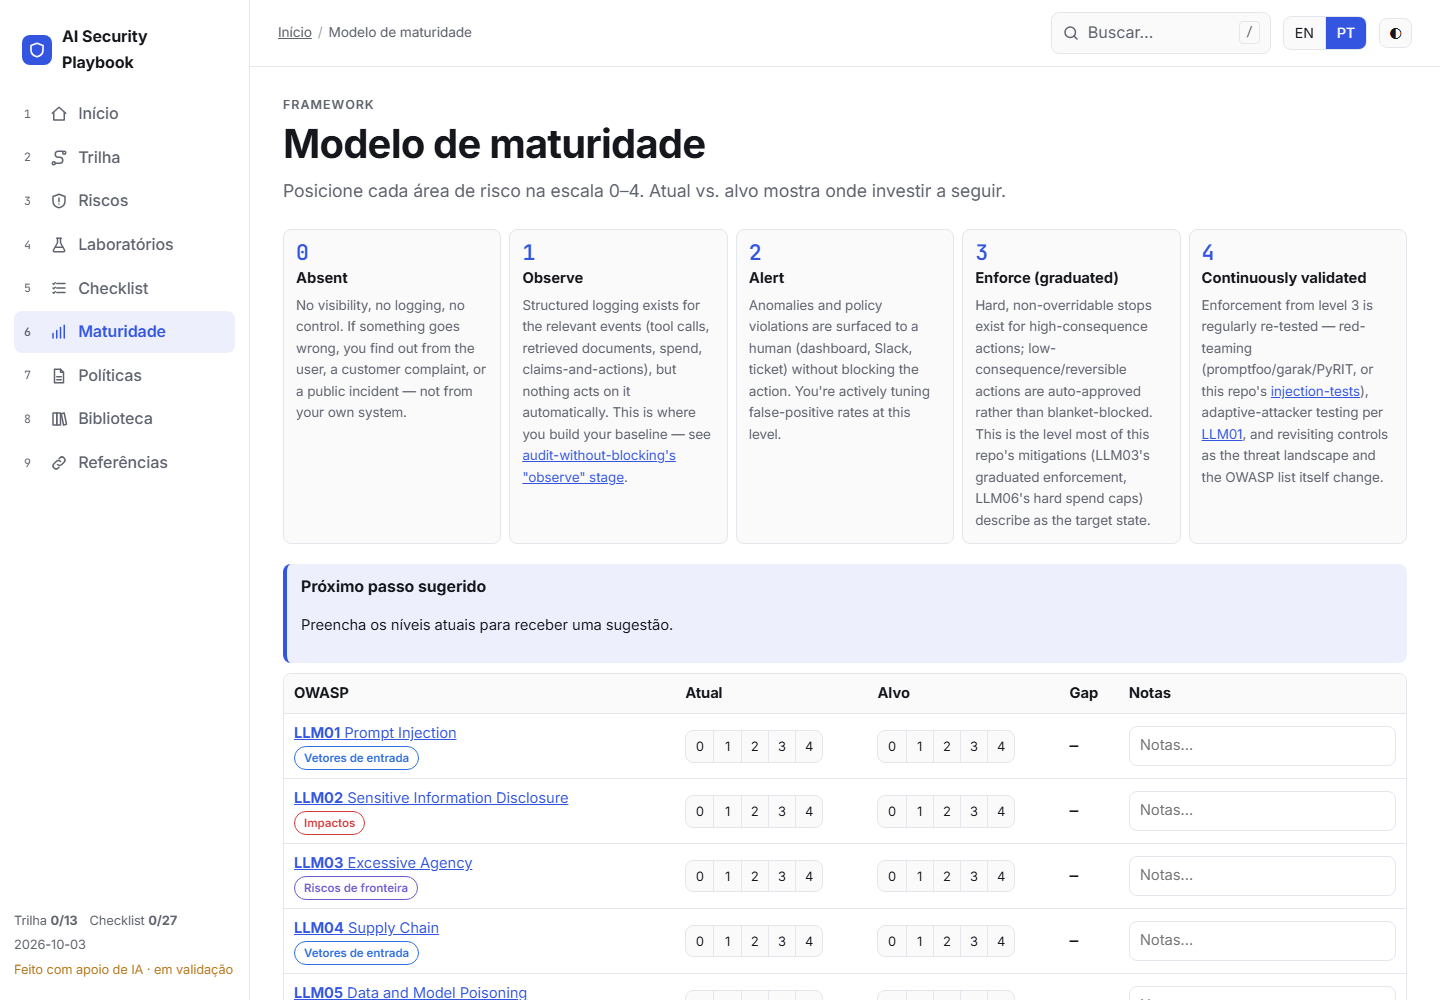
- Modelo de maturidade em 5 níveis, aplicado por risco e não como uma nota única para o sistema inteiro: Ausente → Observar → Alertar → Enforçar → Continuamente validado. Os níveis 1 a 3 seguem o modelo de adoção gradual, e o nível 4 existe porque controles que estavam corretos hoje apodrecem em silêncio quando as técnicas de ataque (ou a própria lista OWASP) mudam.
- Templates para as revisões recorrentes: revisão de risco pré-lançamento, onboarding de ferramenta/skill e registro de incidente.
Existe também um mapeamento para a ISO/IEC 42001. Preciso ser claro, como o próprio repositório é: é um mapeamento de referência, não uma afirmação de conformidade. Selecionar e justificar controles do Anexo A depende de uma avaliação de risco e impacto da organização, e isso não cabe neste projeto.
O explorador visual
Como navegar por dezenas de arquivos Markdown no GitHub não é a experiência mais agradável, criei um site estático que lê o próprio conteúdo do repositório (sem duplicar nada) e oferece trilha guiada, mapa de riscos, checklist interativo, quadro de maturidade, busca e simuladores das políticas de exemplo.
Busquei viabilizar que alguns labs rodassem no próprio navegador. O gateway de ferramentas e o executor de testes de injection são executados com Python compilado para WebAssembly (Pyodide), e os arquivos podem ser editados antes de cada execução. Nada é enviado a lugar nenhum, as respostas do checklist ficam apenas no localStorage do seu navegador e não há backend nem analytics. As bibliotecas de terceiros foram incluídas com versão fixa e hash registrado, e o Markdown renderizado passa por sanitização.
Para o anonimizador, que depende de Presidio e modelos do spaCy e não roda no navegador, existe um simulador didático em JavaScript, útil para entender o fluxo e as falhas, mas que nunca deve ser usado para proteger dados reais.
O que ainda não está pronto
- Os system prompts e os hooks estão documentados e testados internamente, mas ainda não passaram por red team contra um sistema real em produção. Não os trate como fronteiras de segurança validadas.
- Os marcadores
[a verificar]espalhados pelos documentos significam exatamente isso: algo que não consegui confirmar e que foi deixado visível em vez de resolvido no escuro. - O OWASP LLM Top 10 é revisado periodicamente. O repositório acompanha a edição 2026 e vai precisar ser reconferido nas próximas.
- Tudo isso foi montado com IA e passou por minha revisão, mas ainda não auditei e rodei todas as instruções independentemente.
Conclusão
Não faltam repositórios com listas de ferramentas e frameworks, mas quis organizar uma espécie de “curadoria” do que realmente implementar sem ficar sufocado e perdido com as milhares de opções distribuídas por aí.
O projeto é open source (licença MIT) e contribuições são muito bem-vindas: issues e PRs apontando algo desatualizado, errado ou sem citação ajudam a deixá-lo melhor. Dê uma olhada, quebre o que achar que merece ser quebrado se quiser, colabore.
- Repositório: github.com/Gadotti/ai-security-playbook
- Explorador: gadotti.github.io/ai-security-playbook
Referências
Meu projeto e posts relacionados
- ai-security-playbook, repositório no GitHub
- ai-security-playbook, explorador no GitHub Pages
- Nota de verificação da numeração OWASP
- IA everywhere: Teorias, aprendizados e vibe-coding
- IA everywhere: Teorias, aprendizados e vibe-coding - Pt.2
- Por que o agente de IA precisa de uma “jaula”