Como construí a base de um RAG para fornecer inteligência ao suporte e atendimento, estruturando uma base de conhecimento e camada de recuperação a partir de um sistema de chamados legado, utilizando busca semântica híbrida sobre quase 90.000 chamados e mais de 2.000.000 de mensagens gastando pouco mais de US$ 10,00?
Sumário
- Introdução
- Antes do código, estudar
- O método: decisões escritas
- A arquitetura
- Decisões importantes
- Dentro do PostgreSQL
- A IA como auditora
- Detalhe importantíssimo para a eficácia
- Esqueci de algo importante e precisei refazer tudo
- A prova de conceito
- A conta dos 10 dólares
- Próximas partes
- Conclusão
- Um aviso sobre este post
- Referências
Introdução
O ponto de partida é algo precioso que quase todas as empresas possuem, anos e anos acumulados do histórico de mensagens em chamados, onde muitas vezes já documentam resolução de problemas conhecidos e parecidos quando algo é relatado por um cliente, o difícil é achar esta solução no meio de tanta informação.
Em uma primeira etapa a ideia do projeto é uma IA de atendimento que, diante de um chamado novo, sugira ao atendente os possíveis problemas e soluções baseado em conhecimento extraído de chamados parecidos já resolvidos, com a fonte referenciada. O grande desafio antes de qualquer IA consiste em um problema bem menos glamuroso: o histórico não estar pronto para ser lido por uma IA. Este é um case de uma base transacional, antiga e grande, com nomes de clientes, e-mails, telefones, CPFs, senhas e dados de conexão colados no meio do texto, além de muita mensagem automática, assinatura e “bom dia” que não ajudam ninguém.
Este post trata da primeira parte, a base de conhecimento (limpeza, desidentificação e busca), e principalmente de como usei a IA para estudar o assunto, tomar as decisões e medir o resultado, em cerca de três semanas e gastando uns 10 dólares.
Sobre os detalhes: o projeto é um case real. Por isso, nomes de sistema, a estrutura do banco de origem, volumes exatos e qualquer exemplo de texto ficam de fora ou aparecem de forma genérica. A estrutura da base de conhecimento, que é o que interessa aqui, está descrita por inteiro. Os exemplos abaixo são inventados.
Antes do código, estudar
Dado o objetivo e as restrições (LGPD, ISO 27001, isolamento entre clientes), busquei entender com quem já fez algo parecido, como resolver problemas similares. A estratégia foi fazer uso da IA como parceira de estudo e o primeiro passo foi solicitar um levantamento de fontes públicas sobre preparação de base de chamados para IA. Não fiz uma leitura completa de todo material coletado, mas vinculei como base do projeto e direcionador para que a IA ancorasse as premissas corretas para o contexto. As referências que acabaram influenciando o projeto foram:
- O artigo do LinkedIn sobre RAG com grafo de conhecimento montado a partir de chamados de atendimento, publicado no SIGIR 2024.
- O material do Consortium for Service Innovation sobre KCS (Knowledge-Centered Service), que trata o conhecimento como subproduto do atendimento.
- O Contextual Retrieval da Anthropic e o RAG agêntico da Uber, sobre como o pedaço de texto recuperado precisa carregar contexto.
- RAGAS e os estudos sobre LLM como juiz, para pensar em avaliação desde o começo.
- O MTEB-BR, benchmark de modelos de embedding em português.
- Os guias da ANPD sobre anonimização e pseudonimização.
Na minha visão segurança é e sempre foi inegociável, portanto desde o momento zero trouxe como premissa a segurança dos dados que seriam processados, não só pelo risco de vazamento, mas também por conta de conformidade e políticas de termo de uso dos dados coletados. Não é só por capricho, é estar em conformidade com a LGPD, então dados pessoais, como “Fulana de Tal” precisariam ser trocados por [CLIENTE] por exemplo, para reduzir o risco.
Então deste estudo saiu a primeira decisão do projeto: os dados precisariam ser limpos. Nenhuma capacidade de IA seria especificada antes de a base estar definida, limpa e medida, porque a qualidade dela decide tudo o que vem depois.
O método: decisões escritas
A ideia foi trabalhar em especificações, sem nenhuma solução ou método mágico de hype do momento, simplesmente as especificações foram estruturadas antes de qualquer execução, aplicando revisão a cada etapa. Mantive tudo em um arquivo simples, o decisoes.md.
Cada decisão ganha um ID, a data, o que foi decidido, por quê e a consequência. No final de três semanas acumulei um registro de 46 decisões que servem de memória para IA trabalhar no projeto. As dúvidas que eu ainda não sabia responder ficam em outro arquivo.
Duas regras do arquivo merecem destaque:
- Decisão fechada não se reabre sem uma decisão nova que diga o motivo.
- Decisão revertida não é apagada. Ganha uma marca de “revertida em” e aponta para a que a substituiu.
Um exemplo real: num dia decidi que a camada com o texto original seria esvaziada ao fim de cada processamento, para não deixar texto sensível parado no banco. No mesmo dia percebi que precisava dela para recalcular estatísticas do corpus sem reler o sistema de origem a cada mudança de regra. Reverti e resolvi a preocupação original de outro jeito: o segredo sai antes de gravar. As duas decisões continuam no arquivo, e quem ler entende o caminho.
Para trabalhar com IA, isso faz muita diferença já que a cada sessão o agente relê as decisões e não volta a discutir o que já foi fechado, então o contexto fica menor e a conversa mais objetiva. Além disso, fica registrado que quem decide sou eu então a IA recomenda e compara alternativas, e cada decisão no arquivo diz quem a tomou.
O AGENTS.md do projeto completa isso com uma seção de regras duras, que valem para tudo:
- Nenhum dado real no repositório. Teste usa texto inventado.
- Nenhuma credencial no repositório.
- O log nunca registra texto de chamado, só id, contagem, tempo e código de motivo.
- O trecho cifrado do sistema de origem nunca é decifrado.
- Achado de segurança não vai para o código nem para a documentação, vai para SI.
A arquitetura
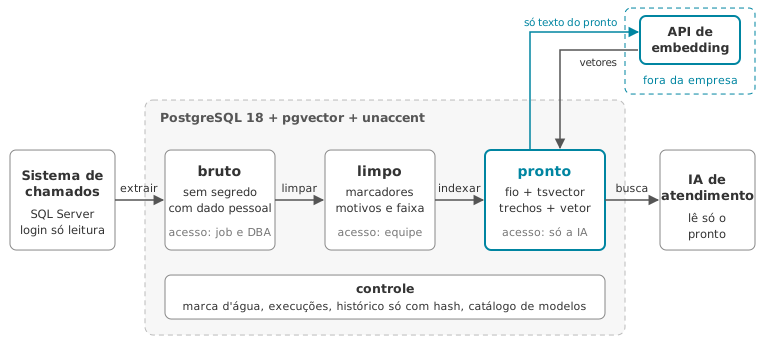
O caminho do texto, da origem até a IA. Em destaque, a camada que a IA lê e o único ponto em que algo sai da empresa.
São três os elementos:
- o sistema de chamados de origem, que o programa só lê;
- um banco de dados PostgreSQL com quatro schemas;
- a API de embedding, que fica fora da empresa e só recebe texto já limpo.
As camadas e o fluxo
brutoé a cópia do recorte: chamados de cliente, concluídos e não sigilosos, a partir de uma data de corte. A data saiu das próprias citações entre chamados, que mostraram que quase todo reaproveitamento real aponta para chamados de até cinco anos. O texto já entra sem segredo, porque a normalização (R2) e os segredos (R5) rodam na extração. O dado pessoal fica, para que a desidentificação possa ser refeita quando as regras mudam, e por isso só o job e o DBA acessam essa camada.limpoé a saída das rotinas. Cada mensagem tem a ação (mantido ou descartado), os motivos e o papel do autor; cada chamado tem metadados, ligações e a faixa de confiança. É a camada que é auditada para avaliar a eficácia da limpeza.prontoé o que a IA lê: o texto de busca com o índice de palavra e os vetores dos trechos. Ele é montado só a partir dolimpo, e nunca dobruto.controleguarda a marca d’água, as execuções, o estado de cada chamado (quando foi extraído, limpo e indexado, e com que versão das regras) e o histórico de cada limpeza sem texto: só a ação, os motivos e um hash de 64 bits do texto limpo. Dá para saber o que mudou de uma execução para outra sem guardar mais uma cópia do dado.
A stack
| Peça | O que usei | Por quê |
|---|---|---|
| Programa | Python 3.12, linha de comando com argparse |
Biblioteca padrão primeiro; dependência nova só com ganho claro, versão e licença conferidas |
| Leitura da origem | pyodbc, com login só leitura |
O programa nunca altera o sistema de origem |
| Banco da base | PostgreSQL 18 com pgvector 0.8.7 e unaccent |
Palavra, vetor, ligações e JSON num banco só |
| Acesso ao banco | psycopg 3 |
COPY para carga em lote |
| Dado pessoal | Regras próprias, pyahocorasick e spaCy pt_core_news_md |
Detalhado na decisão 3, abaixo |
| Vetores | API de embedding da OpenAI, chamada com urllib |
Um endpoint só não justifica um SDK |
| Testes | unittest, com texto inventado |
Nenhum dado real no repositório |
Carga, incremental e implantação
A carga inicial lê o recorte em lotes por faixa de id e o dia a dia foi desenhado para ser incremental. A extração lê só os chamados que mudaram desde o último checkpoint. O chamado que sai do recorte, porque foi reaberto ou marcado como sigiloso, sai também das camadas e quando a versão das regras muda, a limpeza refaz a partir do bruto, sem voltar à origem e consequentemente sem precisar reprocessar tudo novamente.
Aqui a segurança é levada novamente em consideração, pois a estrutura permite que o job do dia a dia use outro login, só de leitura, para nunca alterar nada da base de origem mesmo que o acesso seja comprometido.
No servidor, o processo é iniciado por um único comando que:
- confere a configuração, olhando apenas se as variáveis existem e nunca o valor delas;
- restringe a permissão do
.envà conta que roda; - testa as conexões, inclusive a da API, para a chave errada aparecer antes das horas de carga e não no fim;
- faz a carga marcando cada passo, e rodar de novo continua do passo que falhou.
Decisões importantes
1. A IA nunca lê o sistema de origem
A IA de atendimento vai consultar uma base separada, limpa e desidentificada, alimentada de forma assíncrona, e nunca o banco de produção em tempo de execução. Essa é a decisão que deu origem às camadas da arquitetura acima, onde cada uma tem o seu nível de acesso e pode ser refeita a partir da anterior.
2. Aplicar a regra primeiro. A LLM vem só depois
Esta decisão explica boa parte dos 10 dólares, pois tudo que dá para fazer por regra é feito por regra de forma determinística, porque sai barato, é rápido, dá para auditar e o resultado se repete. O processo inteiro tem entre 10 e 20 rotinas, e só uma delas utiliza de fato LLM que gera o consumo.
Cada rotina é uma função pura, sem acesso a banco, o que permite testar tudo com texto inventado. Esta etapa é muito importante para permitir que o projeto possua sua própria cobertura de testes unitários automatizados, dando mais consistência entre alterações, aumentando assim a manutenibilidade.
A ordem das rotinas também foi pensada e importa:
- Segredos saem logo depois da normalização do texto, antes que qualquer outra etapa, log ou depuração o enxergue.
- O dado pessoal sai antes da detecção de mensagens-modelo. Com o nome trocado por marcador, o mesmo lembrete automático enviado para clientes diferentes vira o mesmo texto, e o catálogo de modelos o reconhece.
- Saudação, fecho, assinatura e rodapé saem depois, só no que sobrou.
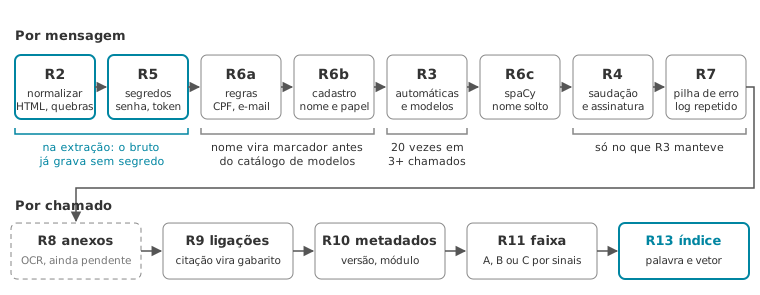
A ordem das rotinas. As duas primeiras já rodam na extração, e a linha de baixo trabalha com o chamado inteiro. O R8 (anexos) ainda está pendente para uma próxima etapa em planejamento.
3. Como identificar e remover os dados pessoais
A desidentificação ficou em três camadas:
- Regras com dígito verificador para CPF, CNPJ e número de processos, além de e-mail, telefone, IP e login.
- O cadastro de pessoas do próprio sistema como dicionário de nomes, buscados todos numa passada com o algoritmo de Aho-Corasick (
pyahocorasick). O marcador diz o papel da pessoa,[CLIENTE]ou[ATENDENTE], para o texto continuar fazendo sentido. - Reconhecimento de entidades com spaCy para o nome que não está no cadastro.
Durante as idas e vindas em meio aos prompts de avaliação, o próprio agente reconheceu que havia um atalho. Para reconhecer nomes de pessoas em português, a ferramenta que eu pensava em usar (o Presidio, da Microsoft, que documentei no playbook) apenas repassava o trabalho para outra, o spaCy. Usar o Presidio nesse contexto significaria instalar mais 31 pacotes só para ter um intermediário para encontrar CPF, e-mail e telefone, sendo que os scripts do projeto já fazem por conta própria. Portanto veio a decisão de usar o spaCy diretamente.
O spaCy oferece modelos de tamanhos diferentes, então o agente fez uma comparação entre o médio, que ocupa 42 MB versus o grande de 568 MB. Numa nota de 0 a 1 que mede a qualidade da detecção, o grande fez 0,903 e o médio 0,896. A diferença é pequena demais para justificar um arquivo 13 vezes maior, então foi adotado o médio que entrega o suficiente.
4. Ninguém vai revisar o passado
No mundo real, não é viável e prático realizar uma revisão humana de todo histórico que será utilizado como base de aprendizado, e mesmo assim a solução precisaria funcionar com o passado como ela está.
A saída foi usar sinais que o sistema já registra para dividir os chamados em três faixas de confiança:
| Faixa | Regra | Uso |
|---|---|---|
| A | Solução marcada e escrita, sem reabertura, cliente respondeu | Pode aparecer como solução sugerida, com a fonte |
| B | Solução marcada, mas com reabertura, sem retorno do cliente ou “conforme anexo” / “por telefone” | Aparece como caso parecido, a verificar |
| C | Sem solução marcada | Só indica que o problema já aconteceu |
A revisão humana passa a acontecer no uso, com um “ajudou / não ajudou”. Além disso, quanto mais os atendentes melhorarem os registros daqui para a frente indicando no histórico se o problema foi resolvido e como foi resolvido, melhor a qualidade que esta solução irá entregar conforme os dias vão passando.
5. Definindo o gabarito
Para medir se a busca funciona, era necessário um gabarito de calibragem que, para cada pergunta, indique qual é a resposta certa. Montar isso à mão exigiria alguém rotulando par por par, e mais uma vez, é inviável executar isso para todo o histórico da base.
A ideia foi se basear em alguns comportamentos que indiquem uma relação de solução, por exemplo quando alguém escreve “ver chamado 123456” em uma mensagem, está dizendo potencialmente que aquele chamado antigo é a resposta para o atual. Cada citação entre chamados virou um par do gabarito. Saiu de graça, sem rotular nada e reflete um reaproveitamento que aconteceu de verdade.
6. A escolha do banco de dados
A base de dados escolhida foi o PostgreSQL com a extensão pgvector e o principal motivo é concentrar tudo em um lugar só. O mesmo banco faz a busca por sentido (vetor), a busca por palavra em português, guarda as ligações entre chamados e ainda oferece um campo flexível em JSON para dados que não têm formato fixo. Dessa forma não precisaria manter um banco vetorial separado, com seu próprio servidor, backup, monitoramento e segurança. Menos peças significa menos coisas para operar e menos pontos de falha.
A parte “chata” é que o pgvector publica apenas o código-fonte e não tem binário pronto para Windows, que era o servidor disponível. A solução foi compilar a extensão localmente, contra o PostgreSQL 18, usando o compilador do Visual Studio. Foi um trabalho extra, mas feito uma única vez. Em troca, ficamos com a extensão rodando no banco que já existia, sem montar uma segunda infraestrutura só para isso.
Dentro do PostgreSQL
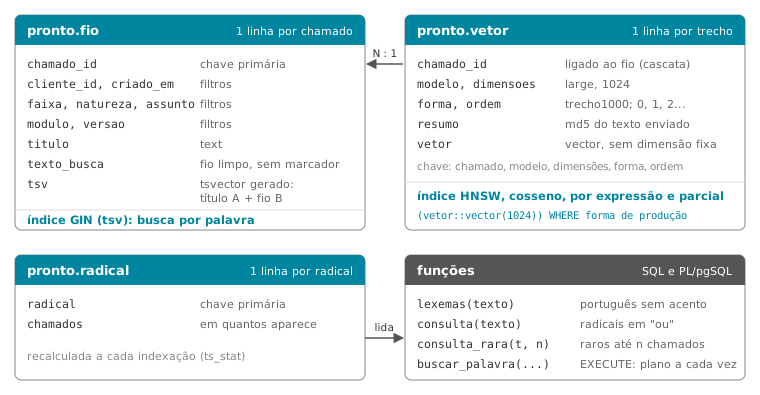
A camada que a IA lê: uma tabela por chamado para a palavra, uma por trecho para o vetor, a contagem dos radicais e as funções de busca.
Busca por palavra
A pronto.fio tem uma linha por chamado, com o título, o texto de busca e as colunas de filtro (cliente, data, faixa, natureza, assunto, módulo e versão). O texto de busca é a descrição mais as mensagens mantidas e não internas, já que as mensagens internas não podem embasar resposta ao cliente, e mensagem descartada só atrapalha a busca. Os marcadores da limpeza ([CLIENTE], [EMAIL]) também saem desse texto, porque, repetidos em todo chamado, só aproximariam casos que não têm nada em comum.
A coluna tsv é gerada pelo próprio banco (GENERATED ALWAYS AS ... STORED), com peso “A” para o título e “B” para o resto, e tem índice GIN. Ela passa pela função pronto.lexemas, onde fica um ajuste para o português sem acento. O radicalizador de português do PostgreSQL só reconhece o sufixo acentuado e não junta “-ão” com “-ões”, e chamado de suporte tem muito “solucao” e “configuracao”. Antes do radical, a função acentua a terminação e passa o plural “-ões” para “-ão”; depois, a extensão unaccent tira o acento do radical. Assim, “solução”, “soluções”, “solucao” e “solucoes” caem todos em soluca.
A consulta (pronto.consulta) transforma a pergunta num “ou” entre todos os radicais dela, e a ordem vem do ts_rank, normalizado pelo tamanho do documento.
pgvector e o índice HNSW
O pronto.vetor tem uma linha por trecho, com a chave (chamado, modelo, dimensões, forma, ordem). A coluna é do tipo vector sem dimensão fixa, o que permitiu guardar modelos, dimensões e formas lado a lado durante a avaliação. A exclusão em cascata tira os vetores quando o chamado sai do pronto.fio.
E aqui o detalhe que economizou chamadas à API foi o modelo text-embedding-3-large, que concentra o mais importante no começo do vetor. Com texto inventado, o vetor de 3.072 dimensões cortado em 1.024 deu cosseno 1,0 com o vetor pedido à API direto em 1.024. Com isso, uma vetorização só serviu para medir 3.072, 1.024 e 256 dimensões, cortando o vetor com subvector no próprio SQL.
A coluna resumo guarda o md5 do texto enviado. Na vetorização, o trecho com o mesmo resumo na mesma posição não vai de novo à API: se um chamado ganhou uma mensagem nova, só o último trecho muda.
O índice:
1 | CREATE INDEX vetor_hnsw_large_1024_trecho1000 ON pronto.vetor |
- É por expressão porque a coluna não fixa a dimensão, e o índice precisa de uma. Além disso, o tipo
vectordo pgvector só indexa até 2.000 dimensões, então 3.072 nem caberiam. - É parcial porque só a configuração de produção precisa de índice. O filtro da consulta tem de vir em literal, igual ao do índice. Com parâmetro, o planejador não consegue provar que a linha está no índice parcial e não o usa.
- Os parâmetros do grafo são os padrões (
m16,ef_construction64). Na busca,hnsw.ef_searchsobe de 40 para 100. Com filtro (por data, por exemplo), a varredura iterativa do pgvector 0.8 (hnsw.iterative_scan) continua percorrendo o grafo até achar os trechos pedidos. - O índice deve ser montado de uma vez, depois da carga, com
maintenance_work_memde 1 GB só naquela transação, porque com o grafo fora da memória a montagem fica muitas vezes mais lenta. Na carga completa, o índice da medição da amostra continuava no banco e recebeu os vetores um a um, o que provavelmente explica parte das 11 horas de vetorização.
A busca de produção
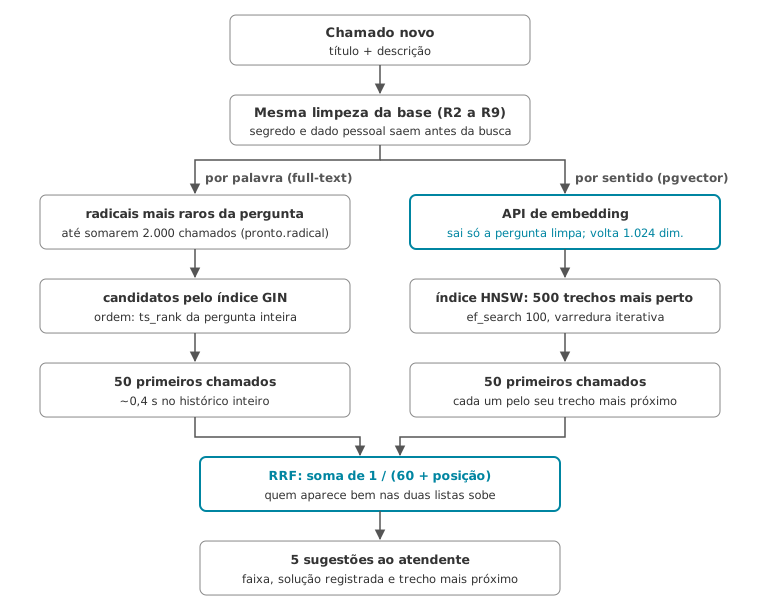
O caminho de um chamado novo até as cinco sugestões. Em destaque, o ponto que sai da empresa e a fusão das duas listas.
A pergunta passa pela mesma limpeza da base, até as ligações (R9), antes de qualquer busca. Se o chamado novo não passasse pelas mesmas regras, ele e o índice ficariam em formatos diferentes, e a busca pioraria. Depois disso, seguem dois caminhos, e cada um devolve 50 chamados:
- Por palavra, a função
pronto.buscar_palavraescolhe os candidatos pelos radicais mais raros da pergunta (a tabelapronto.radicaldiz em quantos chamados cada radical aparece) e os ordena pelots_rankda pergunta inteira. O porquê dos radicais raros está mais abaixo, em No histórico inteiro. - Por sentido, a pergunta limpa vai à API de embedding, e o índice HNSW traz os 500 trechos mais próximos, 10 por chamado pedido. Cada chamado vale pelo seu trecho mais próximo.
As duas listas se juntam por RRF (Reciprocal Rank Fusion): cada chamado soma 1/(60 + posição) em cada lista em que aparece. Quem vai bem nas duas sobe, e não é preciso comparar a nota do ts_rank com a distância de cosseno, que estão em escalas diferentes.
A IA como auditora
A expressão regular não mostra falso positivo nem nome fora do cadastro e para saber se a limpeza funciona, alguém precisa ler o texto e validar. Novamente aqui esbarramos na inviabilidade de fazer o processo manualmente.
Para auxiliar o processo de auditoria, um agente de IA específico com perfil de auditor de limpeza foi definido para execução em paralelo. Ele lê o texto já limpo de uma amostra, sempre por um comando do próprio programa (nunca a camada com o texto original), e aponta, rotina por rotina, quatro tipos de erro: vazamento (dado que devia sair e ficou), falso positivo (marcador onde não havia dado), perda (conteúdo técnico útil que sumiu) e papel errado (atendente marcado como cliente, por exemplo).
Para manter a premissa do controle de vazamento de informações e dados pessoais, o relatório do agente não pode virar mais uma cópia de dado real. Ele nunca reproduz o que achou, só a forma: Nome(5) Sobrenome(7), a***@d***.com.br, 999.999.999-99. E sugere a correção com um exemplo inventado que reproduz o padrão, pronto para virar teste.
O ciclo foi rodar a amostra, auditar, eu decidir o que corrigir, corrigir com teste e rodar de novo e foram dezenas de execuções.
Dois números dão uma ideia:
- A primeira versão do reconhecimento de nomes acertou menos de 2% do que marcou, porque tomava identificador de pilha de erro, tag de XML e nome de verba por pessoa. Depois de três ciclos de filtros, passou de 40%.
- Na validação com 50 chamados que nenhuma regra tinha visto, o descarte indevido ficou em 0,67%, dentro da meta de menos de 2%. Mas 2,5% dos textos ainda tinham algum vazamento, quase todos em formatos que nenhuma regra previa. Cada um virou regra nova e teste que amadurece a cobertura.
É importante destacar que auditar com IA significa enviar o texto, já limpo, ao provedor do modelo e reconhecer que a limpeza não é perfeita nem vai ser, por isso o controle de acesso das camadas e a auditoria por amostragem continuam mesmo com os números bons.
Detalhe importantíssimo para a eficácia
Com o gabarito das citações, toda mudança na busca passou a ser medida. As métricas são o acerto entre os primeiros resultados e o MRR (Mean Reciprocal Rank), que dá mais pontos quanto mais perto do topo aparece a resposta certa.
A primeira medição dos vetores foi um balde de água fria, pois a busca por vetor sozinha perdeu para a busca por palavra em todos os modelos testados. Analisando os erros, a IA identificou que o vetor errava quando o chamado citado tinha um histórico longo, de dezenas de milhares de caracteres. Ou seja, um vetor só para o chamado inteiro mistura todos os assuntos dele, considerando que a pergunta é curta.
Logo, o gargalo era a forma de representar o chamado, e não o modelo. A estratégia foi cortar o histórico em trechos de até mil caracteres, cada um com o título na frente, e o chamado passou a valer pelo trecho mais próximo da pergunta. Depois a lista da busca por palavra foi agrupada com a do vetor pelo RRF, como na busca de produção descrita acima.
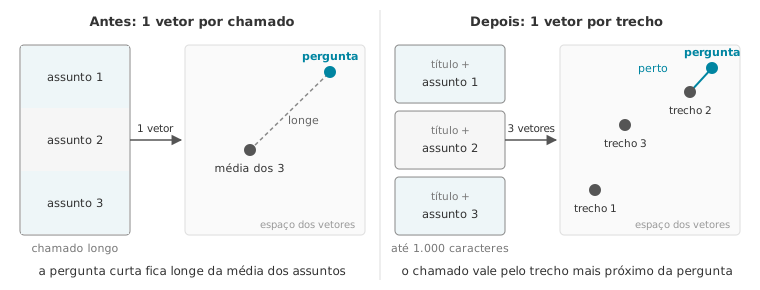
A mudança que fez o vetor passar a funcionar: com um vetor por trecho, a pergunta curta encontra o trecho que trata do mesmo assunto.
| Busca | Acerto no 1º | Acerto nos 5 primeiros | MRR |
|---|---|---|---|
| Palavra | 15 | 24 | 0,550 |
| Vetor, um por chamado | 11 | 18 | 0,410 |
| Vetor, por trecho de 1.000 | 15 | 25 | 0,559 |
| Híbrido, por trecho de 1.000 | 19 | 27 | 0,644 |
35 pares do gabarito, modelo text-embedding-3-large com 1.024 dimensões.
Com 35 pares, um par vale quase 3 pontos percentuais. As diferenças entre modelos (small ou large), dimensões (512, 1.024 ou 3.072) e tamanhos de trecho ficaram dentro do ruído. A troca do vetor único pelo trecho com busca híbrida foi grande o suficiente para eu confiar nela; o resto ficou para a medição no histórico inteiro, mais abaixo.
Sobre o modelo de embedding, o estudo mostrou um modelo aberto empatado com o melhor comercial em português, o que permitiria vetorizar em casa, mas por política interna, ele ficou de fora. A alternativa foi a API de embedding da OpenAI, que dispensa servidor com GPU. Só o texto da camada pronto, já limpo, vai para a API, e os termos de uso (o dado enviado não treina modelo, há retenção para monitoramento de abuso e opção de retenção zero) foram conferidos e validados antes da carga completa.
Também foi medido o índice HNSW do pgvector, que é aproximado. Em vez de comparar a pergunta com todos os trechos, percorre um grafo de vizinhos. Na amostra, trouxe 100% dos resultados da busca exata, mas com pouco mais de mil trechos isso dizia pouco.
No histórico inteiro
Sobre os tempos das primeiras execuções, a carga inicial levou cerca de 45 horas, sendo que só o processo de limpeza tomou quase 27 horas.
Com a base cheia, refiz a medição com 100 perguntas sorteadas do gabarito. Os números caíram bastante:
| Busca | Acerto no 1º | Acerto nos 5 primeiros | Acerto nos 10 primeiros | MRR |
|---|---|---|---|---|
| Palavra | 18% | 26% | 34% | 0,222 |
| Vetor por trecho, pelo índice HNSW | 19% | 28% | 35% | 0,229 |
| Híbrido pelo índice HNSW (o de produção) | 14% | 32% | 41% | 0,213 |
100 perguntas e 130 pares do gabarito, contra o histórico inteiro.
A nota caiu no histórico completo por dois motivos:
- A disputa ficou muito maior. Na amostra de teste, cada pergunta competia com apenas 233 chamados para ser encontrada e no histórico inteiro, são centenas de vezes mais. É como achar uma pessoa numa sala com 233 pessoas e depois num estádio lotado: o mesmo método de busca erra mais, porque há muito mais candidatos parecidos.
- O gabarito aceita como certo um único chamado, o que foi realmente citado na resposta. Se a busca traz outro chamado muito parecido, que também ajudaria o atendente, ele conta como erro. Ou seja, a nota pune resultados que, na prática, seriam úteis.
Portanto, passei a usar essa nota só para comparar uma busca com outra (qual das duas encontra melhor, nas mesmas condições) e não serve como medida de quão boa é a solução para o atendente.
O híbrido ganha nos 5 e nos 10 primeiros e perde no 1º lugar. Como a ideia é mostrar uma lista de sugestões ao atendente, os 5 primeiros pesam mais. O índice HNSW trouxe 98,2% dos 10 primeiros da busca exata e ficou validado.
A surpresa ruim foi o tempo, já que a busca por palavra (instantânea na amostra) levava de 16 a 98 segundos por pergunta no histórico inteiro. A causa principal estava num detalhe do driver: o psycopg prepara a consulta que se repete, e a partir de certo ponto o PostgreSQL passa a usar um plano genérico, que recalcula a consulta da pergunta em cada um dos chamados. A mesma pergunta levou 2,7s com o plano sob medida e 32s com o genérico. A correção foi desligar a preparação no driver (prepare=False) e montar a consulta dentro de pronto.buscar_palavra com EXECUTE, que em PL/pgSQL planeja a cada chamada, com os valores reais. Isso resolveu boa parte do problema, com o resultado idêntico, chamado por chamado.
Para descer dos ~3 s que sobraram, a busca passou a escolher os candidatos pelos radicais mais raros da pergunta, até somarem 2.000 chamados, e só então ordená-los pela pergunta inteira. No primeiro sorteio, além de cair para 0,43s, o acerto até subiu. Porém repeti com outro sorteio e a melhora não se repetiu, deu empate somando as duas rodadas. Então foi adotada a mudança pelo tempo, de uns 3 segundos para uns 0,4 com a mesma qualidade, e não pelo ganho que parecia ter no primeiro sorteio.
Por último, a memória. O PostgreSQL estava com o shared_buffers da instalação (128 MB), e o índice de vetores tem 2,8 GB. Um script subiu o shared_buffers para 1/4 da memória e o effective_cache_size para metade, guardou a configuração anterior, reiniciou o serviço e mediu antes e depois: uma das buscas pelo índice caiu de 25s para 0,14s. Sobrou um caso lento, a busca com um filtro que descarta quase tudo, que hoje só aparece na medição, mas vai aparecer quando a busca filtrar por cliente.
Esqueci de algo importante e precisei refazer tudo
Durante a validação apareceu outro detalhe que mudou a leitura dos números: o atendente muitas vezes reescreve a descrição do problema com mais detalhe, e essa versão passa a ser a oficial. A reclamação de quem abriu o chamado fica só no histórico de alterações e isso eu não havia levado em consideração inicialmente.
Contando no histórico (só contagens e tamanhos, sem ler texto), cerca de 1 em cada 5 chamados tem a descrição refeita, e a versão oficial tem em média o triplo do tamanho da original, de uns 500 para uns 1.500 caracteres. Ou seja, o gabarito perguntava com uma descrição mais rica do que a de um chamado novo, que chega como a reclamação crua. Em um de cada cinco casos, a medida podia estar otimista.
Passei então a guardar as duas versões e fiz uma medição de novo perguntando com a original e a suspeita não se confirmou. A reclamação curta acertou um pouco mais no topo (26 contra 20 no 1º lugar, em 160 pares), porque a descrição longa espalha a busca por palavras genéricas. Com cada par valendo 0,6 ponto, é indício e não prova, mas mostrou que a própria régua também precisa ser medida.
Reclamação de cliente tende a ter mais dado pessoal que texto de atendente, então a original só vai para a API depois de auditada. O auditor leu 50 originais sorteadas e achou uma com dado pessoal, sendo um celular escrito só com espaços, numa forma que nenhuma regra cobria. Virou regra, e a decisão foi limpar a base inteira de novo. Como cada trecho guarda o hash do texto, a vetorização só reenvia o que mudou.
A prova de conceito
Com a base carregada e medida, a decisão foi ver o sistema funcionando antes de ligar o processamento diário. A prova de conceito pega chamados ainda abertos, que são problemas novos para a base (ela só tem concluídos), limpa cada pergunta com as mesmas regras e devolve os cinco casos mais parecidos, com a solução registrada e o trecho mais próximo da pergunta.
Para uma primeira leitura das 100 sugestões, criei mais um subagente, o avaliador-suporte. Ele faz o papel de um especialista de suporte que lê só o relatório e marca cada sugestão como S (resolveria), P (ajudaria em parte) ou N (não serviria), com uma justificativa curta. Com 20 chamados abertos e 5 sugestões cada:
- 13 sugestões S, 23 P e 64 N;
- 15 dos 20 chamados tiveram pelo menos uma sugestão S ou P.
O critério do agente é estrito (“resolveria?” e, na dúvida, N), e o resultado vale como pré-avaliação. Os estudos sobre LLM como juiz que li no começo recomendam calibrar o juiz com a marcação de um especialista humano antes de confiar nele em escala, e esse é o próximo passo.
Onde a ferramenta ainda falha:
Problemas novos, já que a ferramenta aprende com chamados antigos. Quando a causa é nova e nunca apareceu no histórico, não há nada parecido para ela consultar, e a sugestão tende a errar.
Junto com cada sugestão, a ferramenta informa o quanto confia nela (baixa, média, alta). A ideia é que o atendente saiba quando pode confiar e quando deve desconfiar. Só que esse aviso nem sempre acompanha o resultado. Em um caso, ela indicou confiança “média para alta” e errou. Em outro, indicou confiança “baixa” e acertou. Por enquanto, o atendente não deve usar essa indicação como único critério.
A amostra é pequena já que essas conclusões vêm de apenas 9 chamados. Isso é pouco para tirar uma regra definitiva e os resultados mostram uma direção, mas não encerram a discussão. Para evoluir a assertividade basta continuar o teste com mais casos.
A conta dos 10 dólares
| Item | Custo |
|---|---|
| Estudo, especificação e código com IA | A assinatura que já uso no dia a dia |
| PostgreSQL | Licença equivalente de código aberto |
| pgvector, spaCy, pyahocorasick, psycopg | Open source |
| Vetores pela API da OpenAI | Cerca de US$ 10 |
A estimativa inicial, feita pela amostra, era de uns 100 milhões de tokens, até US$ 15 pelo preço de tabela do text-embedding-3-large. A carga completa usou 79,2 milhões de tokens, uns US$ 10 pelo mesmo preço, sem nenhum texto cortado pela API.
O valor baixo vem da soma de algumas decisões:
- Regra em vez de LLM em 12 das 13 rotinas e a limpeza inteira roda em casa, sem chamada paga.
- Só embedding vai para a API, que é de longe o tipo de chamada mais barato.
- O texto enviado já está enxuto, sem mensagem automática, modelo repetido, saudação e assinatura.
- Texto que não mudou não vai de novo. Cada vetor guarda o hash do texto enviado, e o processamento diário só manda o que é novo ou mudou.
- O cliente da API usa a biblioteca padrão do Python, sem SDK, com nova tentativa em erro temporário. É uma dependência a menos para auditar.
Próximas partes
- O processamento diário. A base está como a carga completa deixou, até a prova de conceito terminar.
- Redigir a sugestão com LLM dentro do sistema depende de decisões ainda abertas.
- O cartão de caso e a leitura dos anexos por OCR ainda não foram implementados.
- O juiz LLM ainda precisa ser calibrado com a marcação humana, e o comparativo tem só 9 chamados.
- A busca com filtro muito seletivo continua lenta no disco atual.
Conclusão
A IA ajudou muito no estudo, na comparação de alternativas, na verificação de problemas e na execução. Porém as decisões que fizeram o projeto funcionar vieram de perguntas que eu precisei saber fazer. O que a LGPD diz sobre dado pseudonimizado? Quem vai revisar o passado? Como eu sei que a busca funciona? Por que o vetor está perdendo para a palavra? O desempenho está adequado?
A IA amplifica o que cada um sabe, ela não conhecia as restrições do meu contexto até eu escrevê-las. Depois que eu sabia o que queria, ela implementou, testou e auditou numa velocidade que eu não faria sozinho.
Medir também serviu para corrigir minhas próprias leituras: a estimativa de tempo ficou umas três vezes abaixo do real, o ganho do primeiro sorteio sumiu no segundo, e a suspeita de que o gabarito era otimista precisou de uma medição própria para ser descartada.
Sobre o custo, arrisco dizer que boa parte do gasto com IA por aí vem de usar LLM onde uma expressão regular resolve. Aqui foi regra primeiro, modelo só onde a regra não alcança e medição a cada mudança, e assim a conta não só fechou em 10 dólares, como a solução como um todo ficou otimizada.
É entender e separar o que é processamento determinístico e não determinístico.
Um aviso sobre este post
Não escrevi este post para soar como especialista no assunto, e não sou. Meu objetivo foi descrever o caminho que percorri com a ajuda da IA e o conhecimento de algumas premissas básicas, foi possível navegar até a construção disso. A estruturação do projeto e a explicação mais técnica que aparecem aqui fazem parte desse caminho e foram construídas com esse apoio. A base deste post também foi escrita com a ajuda da IA, a partir do próprio projeto (decisões registradas, código, medições e relatórios), e depois revisada e ajustada por mim. Podem existir escolhas discutíveis, simplificações e caminhos melhores que eu não conheço.
Referências
Posts relacionados
- IA everywhere: Teorias, aprendizados e vibe-coding
- IA everywhere: Teorias, aprendizados e vibe-coding - Pt.2
- AI Security Playbook
Estudos e artigos
- Xu et al. (LinkedIn), Retrieval-Augmented Generation with Knowledge Graphs for Customer Service Question Answering
- Knowledge-Centered Success Practices Guide
- Anthropic, Contextual Retrieval
- Uber, Enhanced Agentic RAG
- RAGAS, arXiv 2309.15217
- Zheng et al., Judging LLM-as-a-judge
- MTEB-BR, arXiv 2607.04581